AIはどうやって絵を作っているの?
多くの画像生成AIは「拡散モデル」です。説明文つきの何百万枚もの画像に加えたノイズを取りのぞく練習をして学びます。新しい絵を作るときは、まったくランダムなノイズから始め、あなたのプロンプトにみちびかれながら、何段階もかけて少しずつノイズを取りのぞき、絵を浮かび上がらせます。写真を貼り合わせるのではなく、新しい画素を作っています。
▶ やってみよう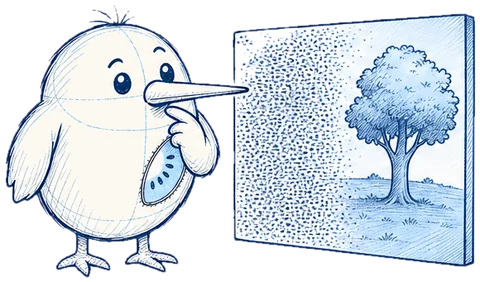
なぜ大切なのか
画像生成AIは、写真を探してくるのでも、かけらをのりで貼り合わせるのでもありません。砂あらしのような画面から始めて、あなたの言葉が指す方向にノイズを取りのぞき続けます。
6分後にできるようになること
- 拡散モデルはランダムなノイズから始めて、一歩ずつノイズを取りのぞきます。
- プロンプトが1歩1歩をみちびき、新しいノイズからは新しい絵が生まれます。
- リアルな画像は証拠ではありません。シェアする前に出どころを確かめましょう。
練習する内容
大事な考え方
カードをタップしましょう。
- 🖼️ 何から学ぶの?
- 文章の説明とセットになった、ばく大な数の画像からです。こうして「キツネ」という言葉を、キツネらしい形や色と結びつけます。
- 🌫️ 学習のゲームは?
- 絵にランダムなノイズを加え、取りのぞけるようにそのノイズをモデルに予測させます。あらゆるノイズの量で、何百万回も練習します。
- 🧭 プロンプトは何をするの?
- あなたの言葉は数に変えられ、そうじの1歩1歩をみちびきます。だからノイズは「キツネ」「本」「ランプ」の方向に取りのぞかれます。
- 🎲 なぜ毎回ちがう絵になるの?
- どの絵も、ちがうランダムなノイズのパターンから始まります。だから同じプロンプトでも、毎回新しい絵になります。
プロンプトから絵まで
絵が1枚できるまでの手順を正しい順番に並べましょう。
- あなたがプロンプトを入力する
- プロンプトが、モデルの使える数に変えられる
- モデルが、まったくランダムなノイズの画面から始める
- プロンプトにみちびかれて、ノイズの一部を予測して取りのぞく
- これを何度もくり返し、1歩ごとに少しずつはっきりする
- 完成した絵が現れる
説明してみよう
AIで作った人物画の片手に、指が6本あります。なぜこうなるの?
- 手の見た目は学んだが、指の本数は学んでいないから (答え)
- 指が6本の人の写真をコピーしたから
AIで作った絵は、ネットの写真をつなぎ合わせたコラージュ?
- いいえ。学んだパターンから新しい画素を作っている (答え)
- はい。本物の写真のかけらを切って貼っている
有名な建物が燃えている、とてもリアルな写真が出回っています。このレッスンからわかることは?
- リアルでも本当に起きた証拠にはならない。まず信頼できるニュースで確かめる (答え)
- こんなに細かいのだからAIではない
覚えておこう
画像生成AIは、あなたの言葉にみちびかれてノイズから絵をほり出します。リアルでも本物とはかぎりません。
画像生成AIは、言葉にみちびかれてノイズから絵をほり出します。リアルでも本物とはかぎりません。
押さえておきたい事実
- データに少しずつノイズを加える過程を逆にたどることを学ぶ、という拡散モデルの考え方は、2015年の研究論文で発表されました。 · 出典: Sohl-Dickstein et al., Deep Unsupervised Learning using Nonequilibrium Thermodynamics, ICML 2015
- 拡散モデルで高品質な画像を作れるようにした2020年の論文では、きれいな画像と完全なノイズのあいだを1,000段階に分けていました。 · 出典: Ho, Jain & Abbeel, Denoising Diffusion Probabilistic Models, NeurIPS 2020
- EUのAI法では、画像、音声、動画、文章を作るAIシステムの提供者は、AIが作ったものだと検出できるよう、機械で読める形で出力に印をつけなければなりません。ディープフェイクを公開する人も、それを明らかにする必要があります。 · 出典: EU Artificial Intelligence Act, Regulation (EU) 2024/1689, Article 50
- C2PA(コンテンツの来歴と真正性のための連合)のオープンな技術標準を使うと、カメラやアプリが画像に「コンテンツクレデンシャル」をつけ、どう作られ、どう編集されたかを記録できます。
更新日:
よくある質問
拡散モデルとは何ですか?
拡散モデルとは、画像からノイズを取りのぞくことを学ぶ生成AIの一種です。絵を作るときは、ランダムなノイズから始め、文章のプロンプトにみちびかれながら一歩ずつきれいにしていきます。
画像生成AIは、今ある画像をコピーしているのですか?
写真を貼り合わせるのではなく、学んだパターンから新しい画素を作っています。ただし画風をまねたり、何度も見た画像をほぼそのまま再現したりすることもあるので、学習データと著作権が議論になっています。
AIが手や文字をまちがえるのはなぜ?
モデルが学ぶのは物のふつうの見た目で、「指は5本」というルールやつづりではありません。手や文字のように複雑で形が変わりやすいものは、パターンだけで正しく作るのがむずかしいのです。
AIで作られた画像かどうか、どう見分けますか?
AI生成の表示やコンテンツクレデンシャルを探し、画像が最初にどこで出たかを確かめ、画像の逆検索をしましょう。見た目の不自然さも手がかりになりますが、それだけで確実にわかる方法はありません。
関連用語